
Vous êtes sur le point d'envoyer un fichier à un client, et le dossier vous propose final_v2, final_FINAL et final-nouveau. Vous en ouvrez un, puis un autre, puis vous écrivez à un collègue pour savoir lequel est parti. Le travail est fait. Le retrouver, c'est ça le problème.
C'est exactement ce que résolvent de solides conventions de nommage des fichiers. Un bon nom dit à un inconnu ce qu'est un fichier, à quoi il appartient et s'il est à jour, sans que personne ait à l'ouvrir. Il doit aussi survivre au voyage vers un autre ordinateur, un disque partagé ou un autre système d'exploitation.
Le modèle de nommage que toute équipe peut copier
Commencez par ce nom :
NORTH-2026-03-14_brand-logo-concept_v03_final.psd
Lisez-le de gauche à droite. NORTH est le projet. 2026-03-14 est la date. brand-logo-concept décrit le contenu. v03 est la version. final est le statut. .psd est l'extension ajoutée par l'application.
L'ordre compte. Mettez l'élément le plus stable en premier, généralement le code projet : un dossier trié regroupe alors le travail par projet, puis par date. Si vous placez la description en premier, les fichiers de projets différents se dispersent dans la liste, et c'est la recherche qui fait le boulot que votre nom aurait dû faire.
Les six éléments, dans l'ordre
| Élément | Modèle | Exemple | Règle |
|---|---|---|---|
| Code projet | 3 à 6 lettres majuscules ou chiffres | ACME | Fixe pendant toute la vie du projet |
| Date | AAAA-MM-JJ | 2026-03-14 | Date de création ou de livraison, précisée dans le guide |
| Description | 2 à 4 mots en minuscules reliés par des traits d'union | brand-logo-concept | Décrit le contenu, pas l'avancement |
| Version | v + deux chiffres | v03 | Augmente à chaque itération enregistrée et envoyée en relecture |
| Statut | draft, review ou final | final | Uniquement sur les livrables |
| Extension | Inchangée, telle que l'application la fournit | .psd | Un seul point final |
Quelques points font trébucher les gens. Votre description doit dire ce qu'il y a dedans, pas son degré de finition. « brand-logo-concept » fonctionne. « nouvelle-version », non, parce que « nouvelle » cesse d'être vrai dès demain. C'est le statut qui porte ce sens, à condition de le limiter à une courte liste. Dès que quelqu'un ajoute « final-ou-presque » ou « validé-peut-être », l'élément statut n'est plus cherchable.
La version est encore une autre chose. Un fichier peut être en v03 et rester un brouillon, ou être en v07 et définitif. Gardez ces notions dans des emplacements distincts et vous n'aurez jamais besoin de noms comme final2 ou final-vraiment-final.
Si vous nommez aussi des produits ou des fonctionnalités, le guide de Sprello sur le nommage de produits est un bon complément : il aborde la même discipline côté nommage, avec des libellés courts, cohérents et faciles à décoder pour les gens de l'extérieur.
Le test de l'inconnu
Avant d'enregistrer, posez-vous trois questions.
- Qu'est-ce que c'est ? La description doit répondre sans ouvrir le fichier.
- À quel projet appartient-il ? Le code doit être évident au premier coup d'œil.
- Est-ce la version actuelle ? La version et le statut doivent trancher.
Vous n'avez pas besoin des six éléments à chaque fois. Une photo personnelle peut se contenter d'une date et d'une description. Ce qu'il vous faut, c'est le même ordre, à chaque fois, pour que les éléments manquants ne décalent pas tout le reste.
Pourquoi les conventions de nommage s'effritent en pratique
Beaucoup d'équipes ne manquent pas d'efforts. Elles manquent d'un accord qui survive à une semaine chargée.
Imaginez un classeur dont les tiroirs n'ont pas d'étiquette. Chaque papier est quelque part là-dedans, mais pour en retrouver un, il faut ouvrir toutes les enveloppes. Un dossier partagé rempli de « présentation », « présentation nouvelle » et « présentation mars » fonctionne pareil. Les fichiers existent. Le système pour les retrouver, non.
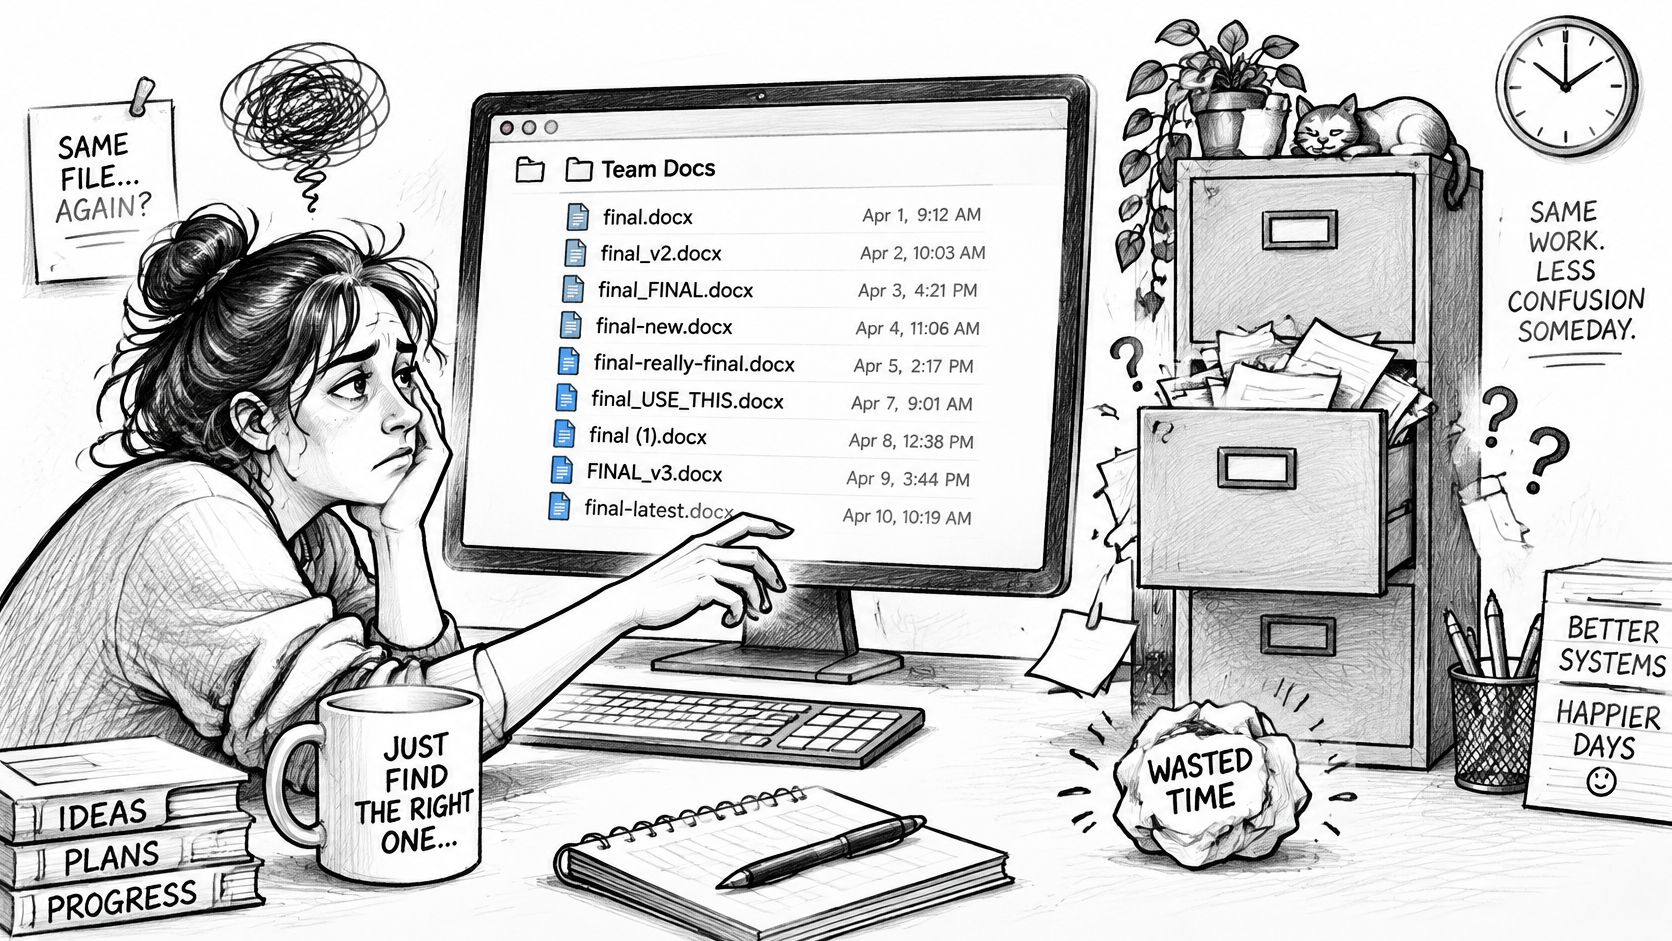
Deux types de dérive causent l'essentiel du désordre.
Les noms dérivent. L'un écrit les dates 14-03-2026, un autre 2026-03-14, un troisième les saute quand la deadline approche. En un mois, le même projet utilise trois formats de date et deux schémas de version, et le tri ne veut plus rien dire.
Les noms n'ont de sens que pour leur auteur. « Brouillon pour Sarah » est clair le jour où vous l'enregistrez. Six mois plus tard, une fois que Sarah a changé d'équipe, ça n'apprend plus rien à personne. Votre futur vous est d'ailleurs un inconnu, lui aussi. Si vous ne savez plus situer un fichier un an plus tard, le nom a échoué, même si c'est vous qui l'avez écrit.
Ce n'est pas un problème rare. Dans une étude intersectorielle de 2026 publiée par Daniel Coward sur LinkedIn portant sur plus de 200 entreprises et environ 10 000 fichiers, 73 % des noms de fichiers présentaient des problèmes tels que des formats de date incohérents, un versionnage flou ou un contexte manquant.
Ce que règle vraiment une convention qui fonctionne
- Retrouvabilité : cherchez un code projet et tous les fichiers associés remontent, même d'un dossier à l'autre.
- Tri : une vue en liste se lit par projet puis par ordre chronologique, sans réorganisation manuelle.
- Passations : designers, développeurs, encadrants et clients identifient le bon fichier sans poser de question.
Le nommage s'inscrit dans un système d'organisation plus large, et les équipes qui gèrent de grandes bibliothèques de ressources trouveront matière à réflexion dans la construction d'une taxonomie de ressources numériques évolutive, qui explique comment catégories et libellés tiennent le coup quand les collections grossissent.
Une convention ne vaut que par l'adhésion de l'équipe. Un modèle parfait dans un document que personne ne lit ne change rien : le processus de construction doit donc créer cet accord au fur et à mesure.
Construire votre convention en six étapes
Voici le processus complet sur une page, avant de le parcourir étape par étape.
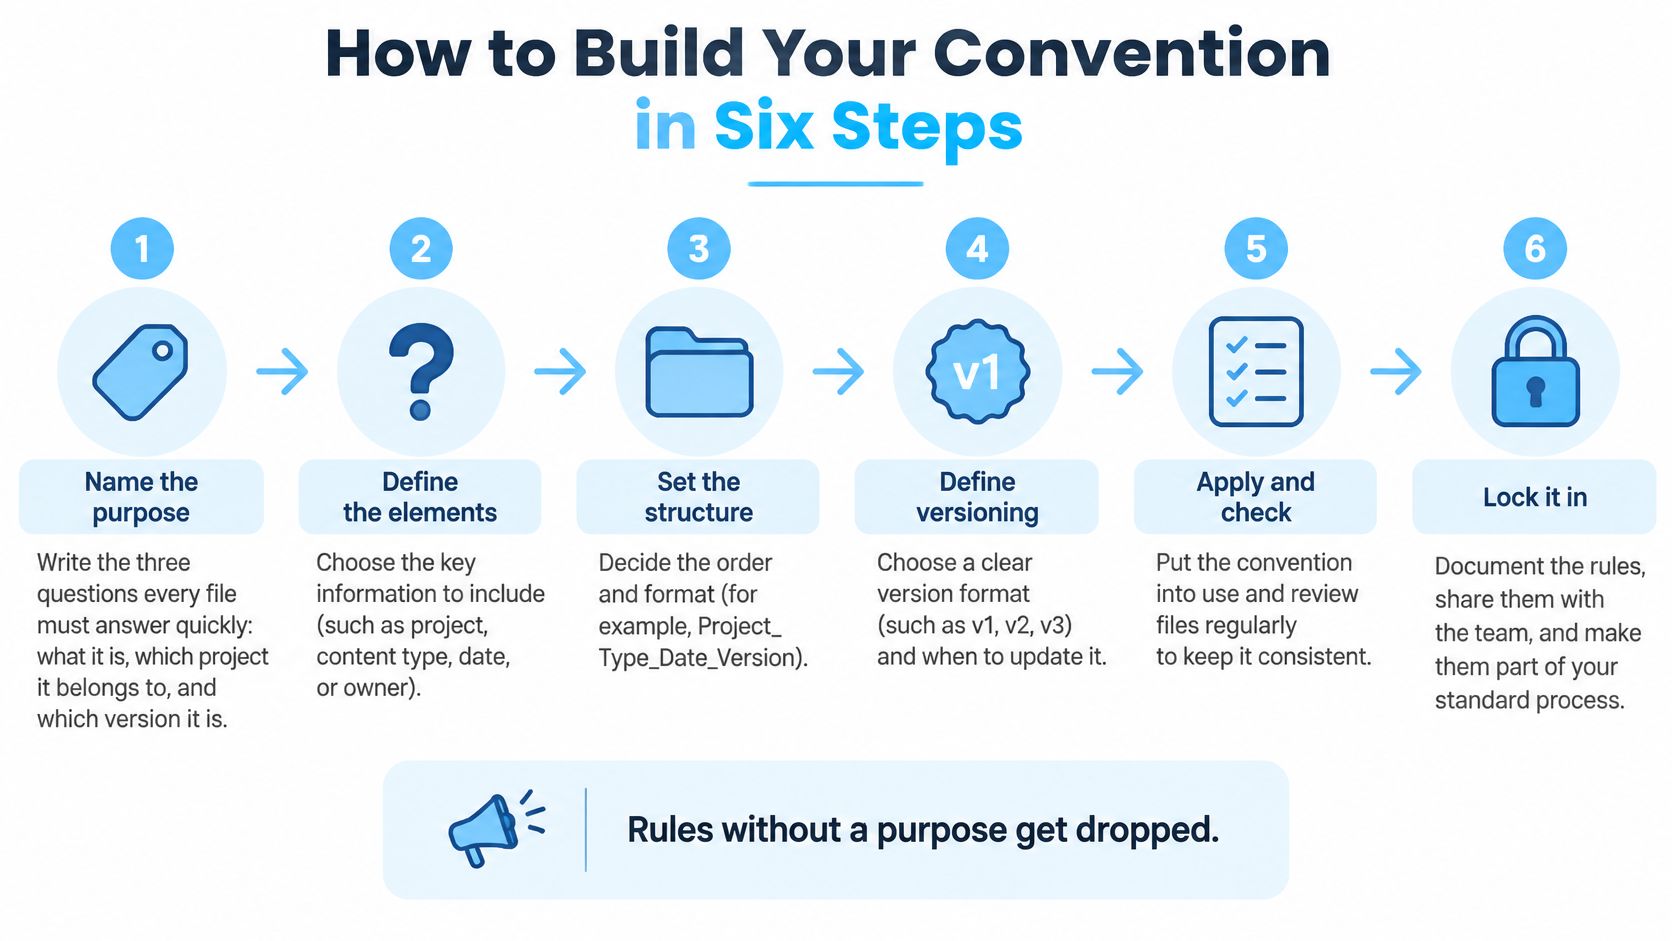
Énoncez l'objectif. Notez les trois questions auxquelles chaque fichier doit répondre vite, généralement : ce que c'est, à quel projet il appartient et de quelle version il s'agit. Des règles sans objectif sont abandonnées dès que l'échéance mord, parce que personne ne sait expliquer pourquoi elles comptent.
Choisissez quatre à six éléments et fixez leur ordre. Piochez parmi le code projet, la date, la description, la version, le statut et le rôle. Le piège à éviter : ajouter des éléments que personne ne renseignera. Si votre équipe n'indiquera pas un lieu ou un contact client sur chaque fichier, laissez-les de côté, car un élément vide une fois sur deux casse le modèle pour tout le monde.
Définissez séparateurs et casse. Utilisez des traits d'union entre les mots d'un même élément et des tirets bas entre les groupes d'éléments, des minuscules partout sauf pour les codes projet, et aucune espace. Les espaces posent problème aux scripts en ligne de commande et à certains liens web, et rendent les noms plus pénibles à sélectionner d'un double-clic. Choisissez un schéma et ne laissez pas les gens mélanger traits d'union et tirets bas à leur guise.
Fixez les règles de date et de version. Les dates sont en AAAA-MM-JJ, les versions commencent à v01, et vous définissez une bonne fois si la date désigne la création ou la livraison. Cette unique définition évite une querelle sourde qui, sinon, dure des années, avec la moitié de l'équipe qui date à la création et l'autre à la livraison.
Regardez ces étapes appliquées dans une courte vidéo avant de rédiger votre propre guide.
Rédigez un guide d'une page. Incluez cinq bons exemples et cinq mauvais, plus une règle pour les exceptions, comme les anciens fichiers que vous ne renommerez pas. Une page, pas plus. Une norme de douze pages signale que le nommage est une lourdeur administrative, et on contourne la bureaucratie. Épinglez cette page là où l'on enregistre les fichiers, pas dans un dossier de procédures que personne n'ouvre.
Testez deux semaines sur un projet en cours. Puis révisez les deux ou trois règles les plus souvent enfreintes. Sauter ce test produit des règles que personne n'applique, car vous découvrirez trop tard qu'un élément est difficile à fournir au moment d'enregistrer.
Quand une règle est sans cesse enfreinte pendant le test, voyez-y une information sur la règle, pas de la paresse de la part de l'équipe.
Comment savoir que ça marche
Les listes triées se lisent comme une chronologie. N'importe qui dans l'équipe retrouve le dernier fichier final en moins de dix secondes, et les nouveaux arrivants nomment correctement leurs fichiers dès le premier jour grâce à la seule page du guide.
Formats de date et de version qui se trient correctement
Ouvrez un dossier contenant 3-4-26, 2-11-26 et 10-3-26. En vue liste, ils se trient sur leur premier caractère : 10-3-26 passe donc avant 2-11-26 et la chronologie est brouillée. Ajoutez maintenant des versions v1, v10 et v2, et l'ordinateur place v10 avant v2, parce que le tri de texte lit caractère par caractère et que « 1 » vient avant « 2 ».
Ces deux problèmes ressemblent à de la négligence. Ce sont des problèmes de format, et ils ont des remèdes mécaniques.
Pourquoi l'année vient en premier
AAAA-MM-JJ se trie chronologiquement dans n'importe quel gestionnaire de fichiers, parce que l'unité la plus grande vient d'abord et que chaque unité a une largeur fixe. JJ-MM-AAAA se trie par jour, si bien que le 1er de chaque mois se retrouve groupé. Et 3-4-26 pose un second problème : il est ambigu entre le 3 avril et le 4 mars selon l'endroit où vit le lecteur, et une année à deux chiffres laisse le siècle à la devinette.
Les recommandations de Microsoft aboutissent à la même conclusion pour le travail multiplateforme. La documentation Microsoft sur le nommage des fichiers soutient les formats à date en tête comme AAAA-MM-JJ pour améliorer le tri lexical, avec des jetons stables de projet et de version qui réduisent l'ambiguïté lors des traitements par lots.
Séparer la date et la version
La date consigne quand un fichier a été créé ou livré. La version consigne de quelle itération du travail il s'agit. Ce sont deux faits différents : deux fichiers du même jour peuvent différer par la version, et une même version peut être relivrée à une date ultérieure. Fusionnez-les et vous perdez l'une des deux informations.
Le remplissage par des zéros est ce qui permet aux versions de se trier. Écrivez chaque numéro sur deux chiffres, de v01 à v99, pour que v02 se place avant v10. Si un projet dépassera clairement quatre-vingt-dix-neuf itérations, commencez directement à v001 plutôt que de changer de système en cours de route.
Des jetons stables aident aussi les scripts. Un code projet fixe et un petit jeu de mots de statut permettent à un outil de traitement par lots de repérer les fichiers de façon fiable, ce qui explique pourquoi un guide sur le renommage de fichiers par lots sur Mac vaut la peine d'être lu une fois votre modèle arrêté. Les équipes qui manipulent beaucoup de données reconnaîtront la même rigueur dans les approches pour gérer les versions de données de robotique, où un jeton de version doit rester sans ambiguïté sur de nombreuses exécutions automatisées.
Pour les équipes réparties sur plusieurs fuseaux horaires, datez la livraison dans le fuseau horaire de l'équipe et inscrivez cette règle dans le guide, afin qu'un fichier envoyé vers minuit reçoive une seule date convenue.
| Erreur | Pourquoi ça casse | Meilleur format |
|---|---|---|
| Dates écrites 3-4-26 | L'année et le jour se trient dans le mauvais ordre | 2026-04-03 |
| Versions v1, v10, v2 | Le tri de texte place v10 avant v2 | v01, v02, v10 |
| final, final2, FINAL-nouveau | Aucun ordre et aucun dernier fichier identifiable | v04 plus statut final |
| Date du dernier enregistrement utilisée comme date de livraison | Chaque nouvel enregistrement change la date | Date de livraison dans le nom du fichier, pas la date d'enregistrement |
| Ordre jour-mois mélangé dans l'équipe | Des dates comme 03-04 sont ambiguës | AAAA-MM-JJ dans toute l'équipe |
Terminons par une règle qui évite l'inflation des versions. Augmentez la version à chaque enregistrement envoyé à quelqu'un d'autre, pas à chaque enregistrement que vous faites. Vos sauvegardes de travail locales ne regardent que vous. Le numéro de version est un outil de communication à destination des autres.
Caractères, accents et longueurs qui font échouer les transferts
Voici une idée reçue qui mérite d'être contestée. Si votre Mac accepte un nom, le nom est correct.
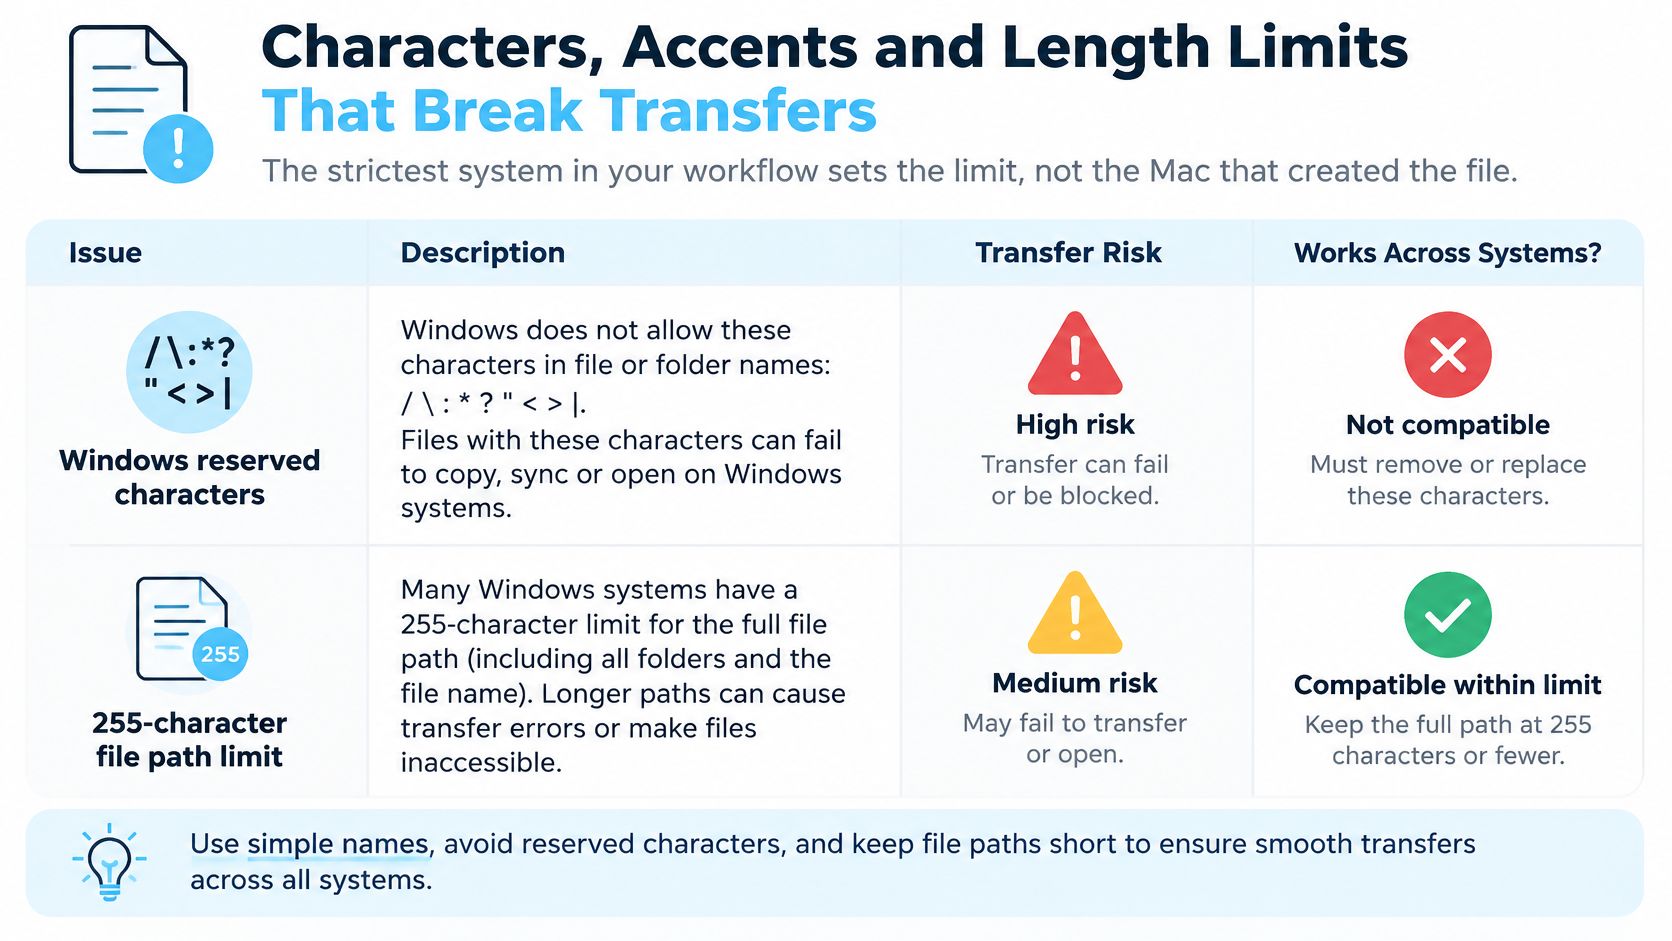
Faux. C'est le système le plus strict de votre chaîne de travail qui fixe la limite, pas le Mac qui a créé le fichier. Un nom parfaitement légal chez vous peut échouer à la copie vers un volume Windows, être renommé par un service de synchronisation ou devenir inaccessible au fond d'une arborescence profonde. La plupart des conseils de nommage s'arrêtent à la lisibilité. Le risque de transfert, lui, est ce qui fait perdre des fichiers.
| Contrainte | Où ça échoue | Pratique sûre |
|---|---|---|
| Caractères réservés : < > : guillemet double / \ | * | Volumes Windows, synchronisation cloud, archives zip | Lettres, chiffres, traits d'union et tirets bas uniquement |
| Limite de 255 caractères par nom | Longues descriptions sous Windows et sur les partages réseau | Garder chaque nom bien en dessous de 255 octets |
| Limite de 260 caractères par chemin (MAX_PATH) | Arborescences profondes copiées vers Windows | Limiter la profondeur à environ quatre niveaux |
| Noms de périphériques réservés CON, PRN, AUX, NUL | Machines Windows | Ne jamais les utiliser comme noms de fichier ou de dossier |
| Point ou espace en fin de nom | Windows les supprime ou les rejette | Les retirer avant d'enregistrer |
| Accents décomposés (NFD) | Scripts Linux, Git et outils de synchronisation | Normaliser en NFC et tester la longueur en octets |
| Longueur de plus de 255 octets | Noms accentués après transfert | Vérifier le nombre d'octets sur le véritable chemin de transfert |
Le problème des accents, en clair
Une lettre accentuée peut être stockée de deux façons. Soit comme un seul caractère précomposé, soit comme une lettre de base plus une marque combinante distincte. À l'écran, elles paraissent identiques.
Comme l'explique le guide Unicode dans les noms de fichiers, macOS expose couramment des noms décomposés, de type NFD, alors que les environnements Linux utilisent souvent NFC ou laissent la normalisation telle quelle. Ce décalage peut créer des noms de fichiers qui semblent en double, des comparaisons qui échouent, des scripts cassés ou des conflits de synchronisation, même quand les utilisateurs voient un texte identique.
Il y a un second piège. La longueur d'un nom de fichier se mesure en octets et non en caractères visibles, et décomposer les caractères accentués fait grimper le nombre d'octets. Un nom qui semble sous la limite peut donc dépasser la limite de 255 octets par composant après un transfert ou un traitement. C'est pourquoi compter les caractères dans le Finder donne un faux sentiment de sécurité.
Le compromis honnête des noms 100 % ASCII
Se limiter à l'ASCII pur améliore l'interopérabilité. Mais cela sacrifie l'accessibilité, la recherche et la justesse culturelle, parce que cela impose une orthographe incorrecte en espagnol, en allemand, en japonais et dans bien d'autres langues. Dire à un collègue d'écorcher son propre nom pour qu'un script fonctionne, ce n'est pas une politique, c'est une démission.
Utilisez plutôt une approche en couches.
- Gardez le nom d'affichage dans la langue d'origine. Les noms de personnes et de lieux restent correctement orthographiés là où les humains les lisent.
- Normalisez en NFC avant d'enregistrer quand vos outils le permettent, pour que tous les systèmes comparent la même suite d'octets.
- Conservez un slug ASCII comme identifiant machine. Les scripts et les outils de synchronisation s'appuient sur le slug pendant que les gens lisent le nom d'affichage.
- Testez le vrai chemin de transfert. Faites faire un aller-retour à des fichiers d'essai par le NAS, le disque cloud ou le dépôt Git que votre équipe utilise réellement.
Unicode est acceptable. Normalisez-le de façon cohérente, validez la longueur en octets et vérifiez qu'il survit au voyage.
Modèles par métier : créatifs, développeurs, étudiants et chercheurs
Les mêmes éléments valent pour tous les métiers. Ce qui change, c'est l'élément qui pèse le plus, car chaque métier souffre d'un type de confusion différent.
| Métier | Modèle | Exemple | Élément prioritaire |
|---|---|---|---|
| Créatifs (design, photo, vidéo) | Client_AAAA-MM-JJ_ressource_vNN.ext | ACME_2026-03-14_homepage-banner_v03.psd | Version et type de ressource |
| Développeurs | projet_composant_typedoc_vNN.ext | shop-api_auth-flow_spec_v02.md | Composant et type de document |
| Étudiants | Cours_devoir_nom_vNN_statut.ext | HIST201_essay1_smith_v02_final.pdf | Code du cours et statut |
| Chercheurs | IDétude_AAAA-MM-JJ_typedonnées_vNN.ext | ECO07_2026-02-11_survey-raw_v01.csv | ID de l'étude et brut ou nettoyé |
Les créatifs commencent par le code client ou projet et le type de ressource. Une seule campagne peut compter des centaines d'itérations de la même bannière : la version doit donc être sans ambiguïté et le type de ressource doit distinguer d'un coup d'œil une bannière de page d'accueil d'un recadrage pour les réseaux sociaux. Sans l'élément ressource, vous ouvrez les fichiers pour vérifier les dimensions.
Les développeurs travaillent dans des dépôts qui imposent déjà des noms en minuscules et sans espaces : ne luttez pas contre le dépôt. Utilisez plutôt le nom pour le composant et le type de document. shop-api_auth-flow_spec_v02.md dit exactement à un relecteur quelle partie du système il décrit, ce qui compte plus qu'une date que l'historique des commits consigne déjà.
Les étudiants doivent d'abord suivre ce que précise l'enseignant. Quand rien n'est précisé, le nom doit porter le code du cours, le devoir et le statut de remise, pour qu'un correcteur qui traite toute une classe retrouve votre travail en quelques secondes. Un nom de famille aide quand les rendus arrivent dans une seule boîte partagée.
Les chercheurs ont les enjeux les plus élevés. Nommez différemment les données brutes et les données nettoyées, passez les fichiers bruts en lecture seule et ancrez tout sur un identifiant d'étude et une date. Si les données nettoyées écrasent les brutes sous le même nom, l'étude n'est plus reproductible.
Gérer les exceptions sans casser le système
Parfois, une plateforme impose ses propres règles. Un portail de dépôt peut renommer les envois, ou un outil exiger un modèle précis. Suivez la plateforme, et consignez le nom lisible par un humain dans un README ou un index de projet pour que le lien ne se perde pas.
Il en va de même entre les langues. Le nom d'affichage peut rester dans la langue d'origine tandis que l'identifiant machine reste en ASCII, ce qui contente à la fois les gens et les outils.
Le nommage fonctionne mieux quand l'arborescence des dossiers porte une partie de la charge : associez donc ces modèles à une structure de dossiers de projet sensée plutôt que de forcer chaque information dans le nom de fichier. Si vous entassez client, campagne, région et canal dans un seul nom, une partie de tout cela a sa place dans les dossiers.
Adopter une seule convention et automatiser les vérifications
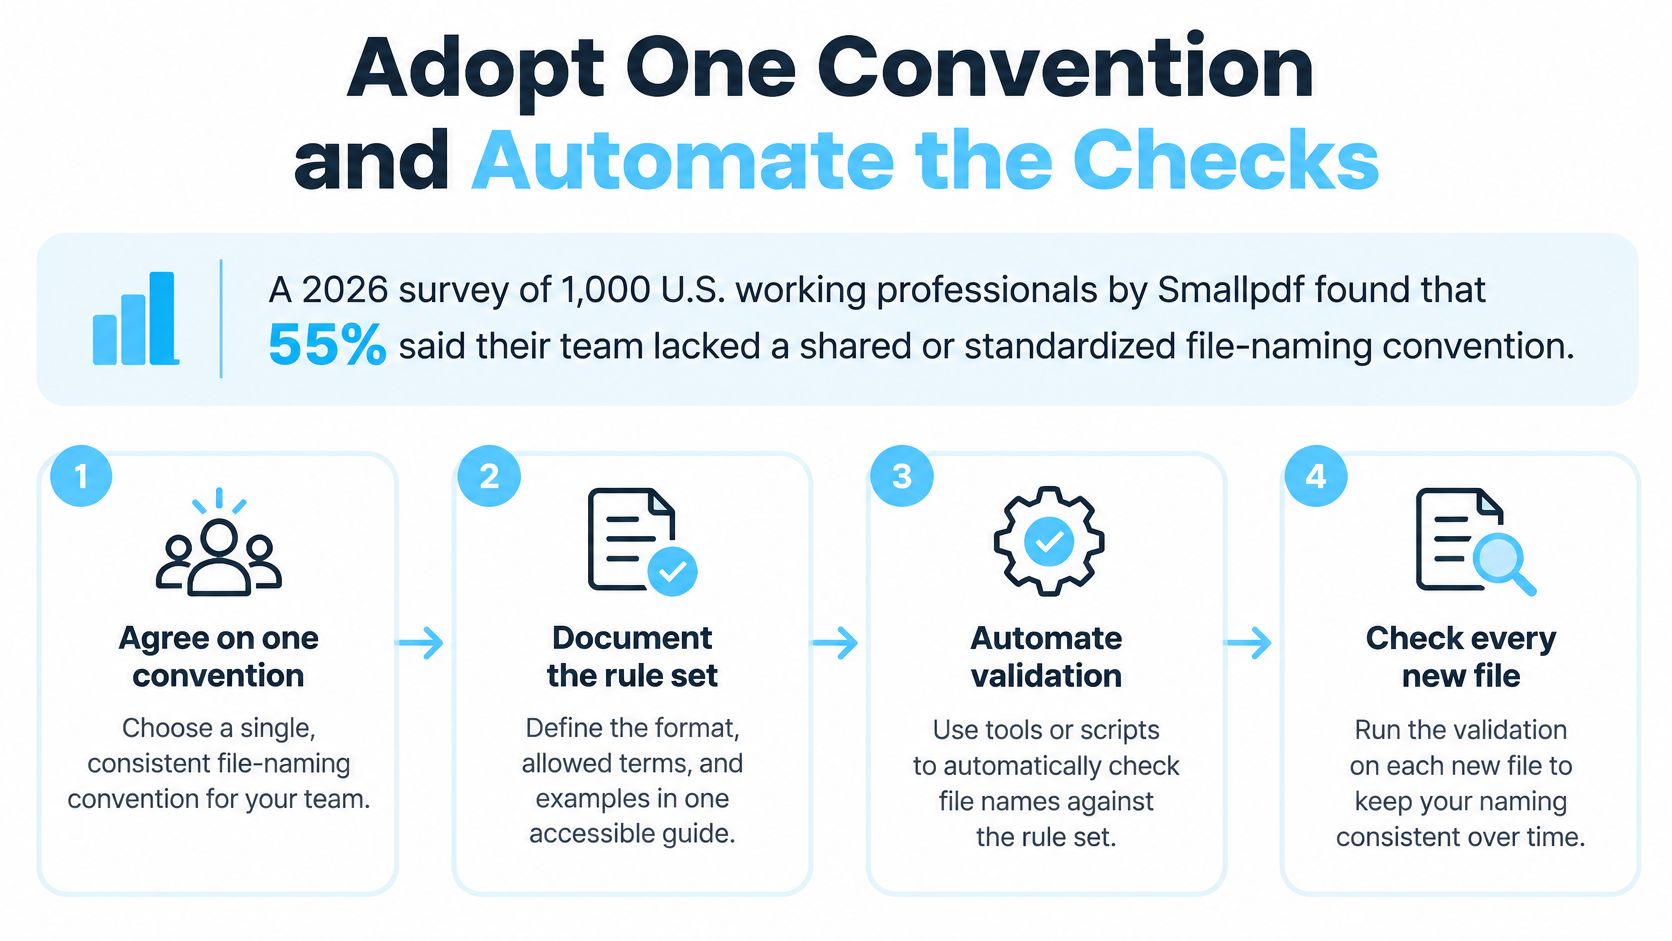
Beaucoup d'équipes ne concluent jamais cet accord au départ. Dans l'enquête 2026 de Smallpdf auprès de 1 000 professionnels américains en activité, 55 % ont déclaré que leur équipe n'avait aucune convention de nommage commune ou standardisée.
L'adoption passe donc avant l'application. Publiez le guide d'une page, faites-le valider par les personnes qui créent les fichiers et appliquez-le à un projet en cours avant de le déployer partout. Une convention annoncée par e-mail à toute l'organisation a tendance à mourir avant vendredi.
Trois niveaux d'automatisation
Le niveau un vérifie les fichiers à leur arrivée. Définissez des règles de renommage sur les dossiers entrants, comme une action de dossier Automator sur macOS ou un outil de surveillance de dossier qui signale ou corrige les nouveaux téléchargements. Si vous hésitez entre plusieurs options, ce tour d'horizon des applications d'automatisation pour Mac présente des outils capables de surveiller des dossiers et d'agir sur les nouveaux fichiers.
Le niveau deux audite l'existant. Un court script sous Windows ou Linux peut lister tous les fichiers qui ne respectent pas le modèle, en se fondant sur le même ordre d'éléments que dans votre guide. Lancez-le sur un dossier de projet et vous verrez tout de suite la dérive, y compris qui a besoin d'une piqûre de rappel.
Le niveau trois suit la tendance. Lancez un audit trimestriel qui compte les noms non conformes et tracez ce nombre dans le temps. Un nombre en baisse dit à l'équipe que l'habitude s'installe. Un nombre en hausse signifie qu'une règle est trop difficile à suivre et qu'il faut la revoir, pas durcir l'application.
Que faire des fichiers existants
Ne renommez pas une archive à l'aveugle. Conservez un tableau de correspondance entre anciens et nouveaux noms pour pouvoir réparer les liens dans les documents, les tickets et les e-mails quand ils se cassent. Renommez d'abord les projets actifs et laissez tranquilles les archives closes, sauf si quelqu'un les consulte encore.
Faites une chose cette semaine. Prenez votre prochain projet, écrivez son modèle sur une page, renommez un dossier en conséquence et mettez en place une vérification qui s'exécute à chaque ajout de fichier. Ce petit exemple concret convainc bien mieux les gens qu'une annonce de politique interne.
Une fois vos noms cohérents, rendez les dossiers eux-mêmes plus faciles à repérer. Tintd lit le nom d'un dossier et choisit une icône et une couleur assorties, et son Folder Watcher stylise automatiquement les nouveaux dossiers dans les emplacements de votre choix : un projet bien nommé est ainsi aussi immédiatement reconnaissable dans le Finder. Découvrez Tintd pour voir comment l'organisation visuelle peut s'ajouter au système de nommage que vous venez de construire.